Fallstudie · Full-stack ITSM
DeskFlow
Att bygga de delar av en servicedesk som är lätta att få nästan rätt
DeskFlow är en liten helpdesk i ServiceNow-stil: ärenden med SLA-timers, ett hårdvaruregister, en kunskapsbas och en valfri AI-assistent. Jag byggde den på egen hand, från datamodell till driftsättning, för att lära mig vad som gör den här sortens system pålitliga.
- Roll
- Eget projekt: design, backend, frontend, tester och driftsättning
- När
- 2026
- Teknik
- Angular
- Angular Material
- TypeScript
- FastAPI
- SQLAlchemy
- PostgreSQL
- Redis
- Alembic
- Claude API
- Docker
- nginx
- Railway
- GitHub Actions
01.Problemet
En helpdesk är bara användbar om man kan lita på det den visar. En handläggare behöver veta vilka ärenden som snart bryter mot sin SLA. En administratör behöver veta vem som ändrade vad, och vara säker på att ingen i tysthet ändrade tillbaka det. Och ett AI-förslag är sämre än inget om det hittar på en lösning.
De tre sakerna – tid, historik och AI-svar – är vad jag fokuserade på. Ärenden, register, roller och sökning måste också vara stabila, men det här är delarna som är lätta att bygga så att de ser rätt ut men är fel i detaljerna.
02.Viktiga beslut
01En enda modul avgör varje SLA-status
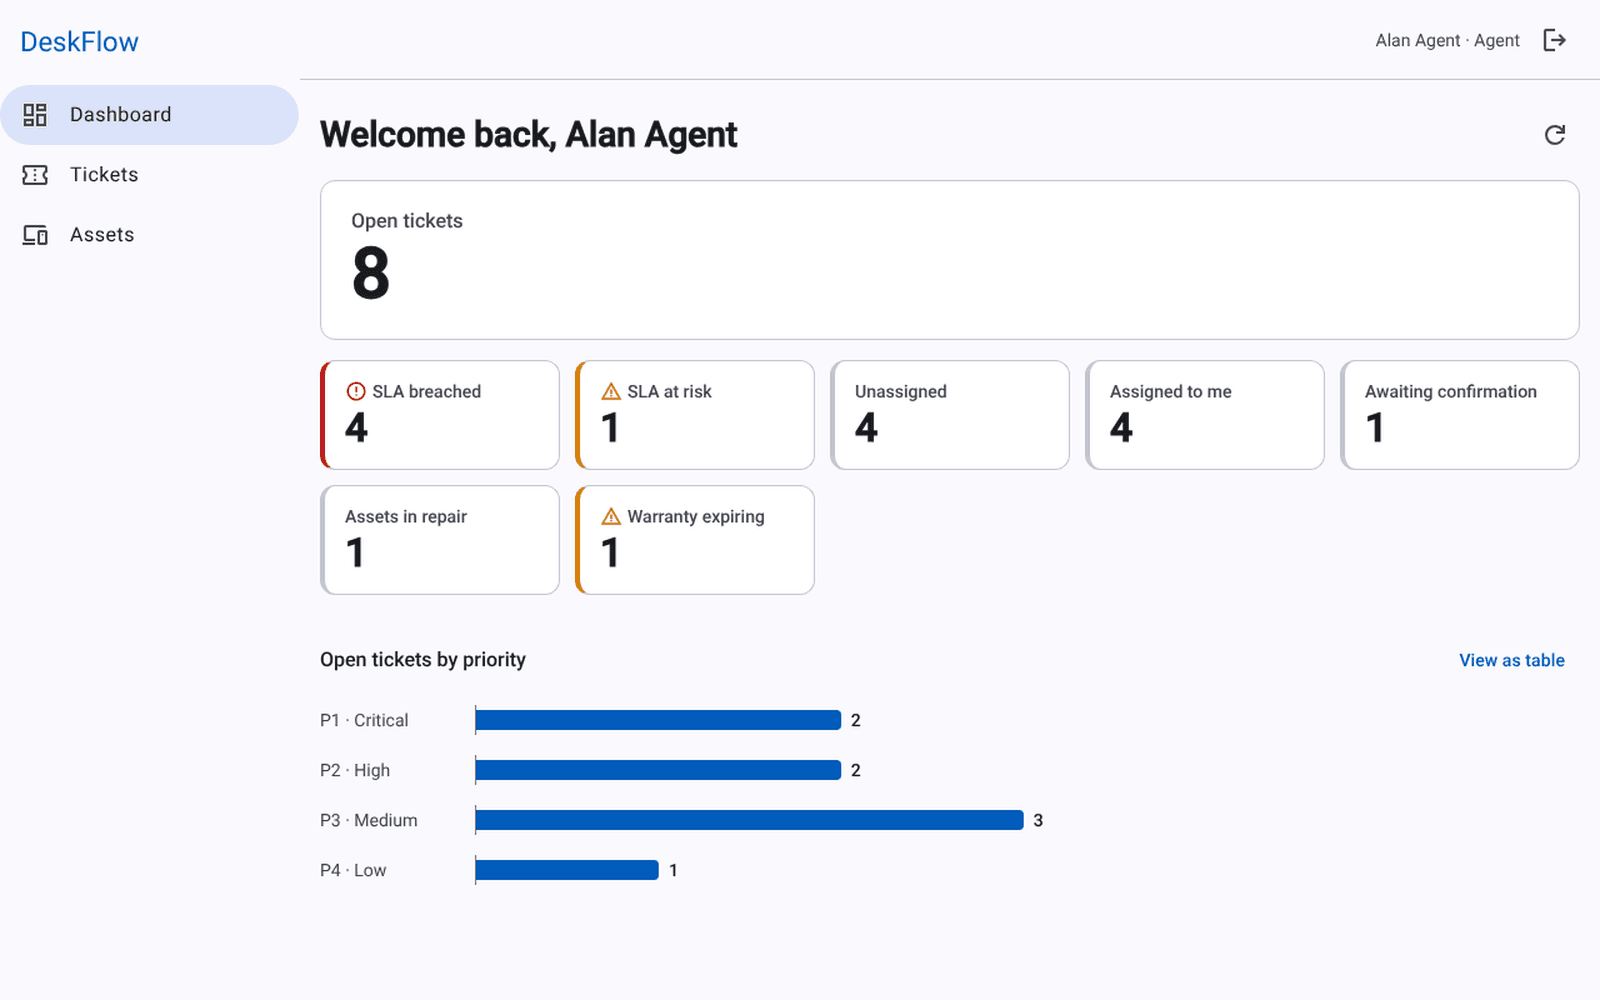
SLA-status syns på fyra ställen: ärendesidan, dashboardens rutor, filtret i ärendelistan och en bakgrundsworker som flaggar ärenden i riskzonen eller över tiden. Om varje ställe räknade ut den själv skulle de förr eller senare visa olika – ett ärende ”i riskzonen” på dashboarden men som saknas i filtret.
Därför anropar alla fyra samma modul. Varje prioritet har ett mål för första svar och ett för lösning, sparade som deadlines på ärendet. När ett ärende sätts till Väntar pausas båda klockorna, och när det lämnar Väntar flyttas deadlines fram med den tid det väntade. Ett ärende är i riskzonen när 75 % av tiden har gått.
Avvägning: Klockorna går i kalendertid, inte arbetstid. Det höll reglerna enkla nog att testa ordentligt, men det är den största skillnaden mot en riktig servicedesk.
02En granskningslogg som ingen kan skriva om
Varje ändring av ett ärende, en tillgång eller en artikel sparar vem som gjorde den och värdena före och efter, i samma databastransaktion som själva ändringen. En förfrågan som misslyckas lämnar inga spår, och en som lyckas kan inte hoppa över loggen. Poster läggs bara till, och de finns kvar efter att posterna de beskriver har tagits bort: en post om något som raderats visas som ”raderad” i stället för en trasig länk.
Den publika demon återställs varje natt så att besökare alltid möter en realistisk helpdesk. Första versionen av återställningen tömde granskningsloggen tillsammans med ärendena. Demon blev prydlig men loggen meningslös, så jag ändrade det: återställningen lägger bara till i loggen och skriver vad den tog bort och skapade, och id:n återanvänds aldrig, så en gammal post kan aldrig börja beskriva något nytt.
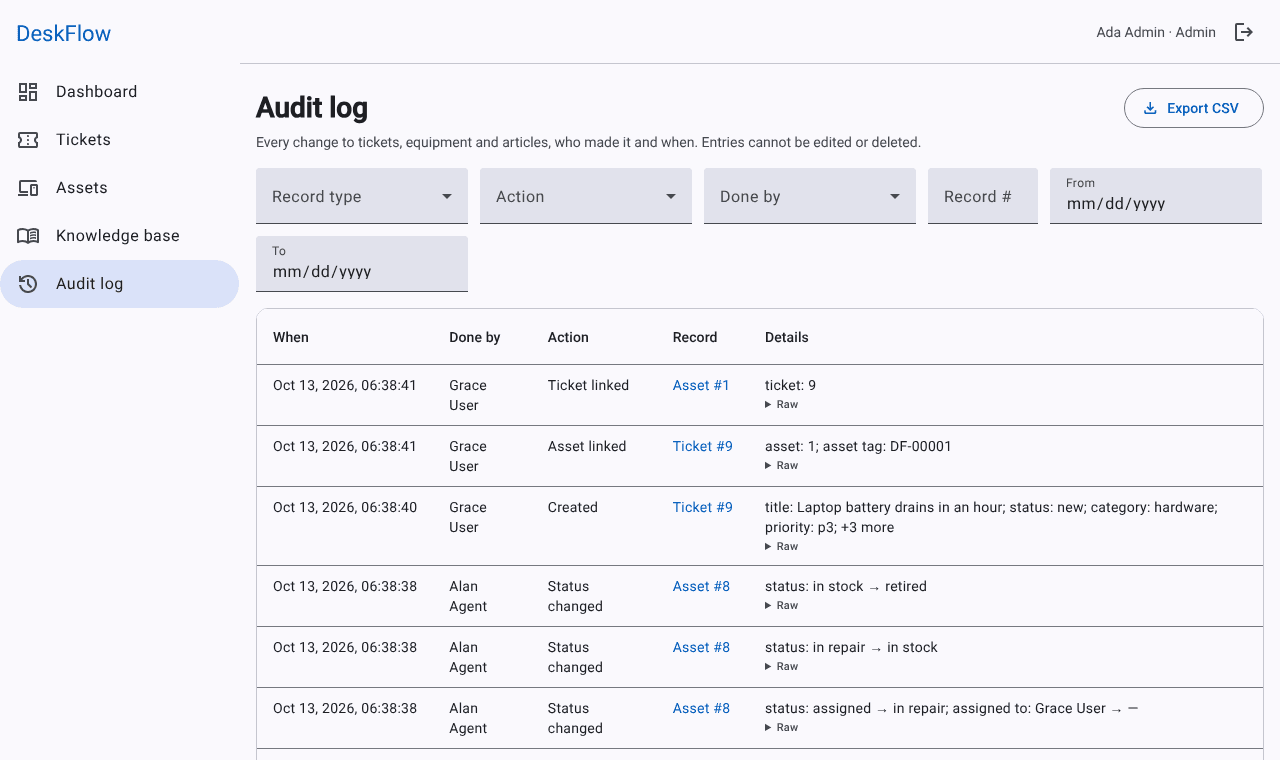
Granskningsloggen för administratörer: varje ändring med vem, vad och före → efter, med filter och export. Poster kan inte ändras eller raderas. 03En AI-assistent som bara kan återge kunskapsbasen
Assistenten föreslår felsökningssteg för ett ärende, men modellen får bara se upp till fyra publicerade artiklar ur kunskapsbasen, hittade med samma fulltextsökning som resten av appen. Om inget matchar anropas modellen inte alls.
Den måste ange vilka artiklar den använde. Id:n den hittat på tas bort, och ett svar som inte hänvisar till något den fått kastas och visas som ”täcks inte”. Ärendetexten skickas som data med en instruktion att inte följa något i den, svaret går genom samma sanering som artiklarna, och den utför aldrig något själv – det är råd för en människa att granska. Den körs bara när en handläggare ber om det, har en gräns för antal anrop och varje körning loggas.
Avvägning: Att hålla den så strikt till källorna gör att den ofta svarar ”täcks inte”. För en helpdesk är det rätt sätt att misslyckas: en felaktig lösning kostar mer än inget förslag.
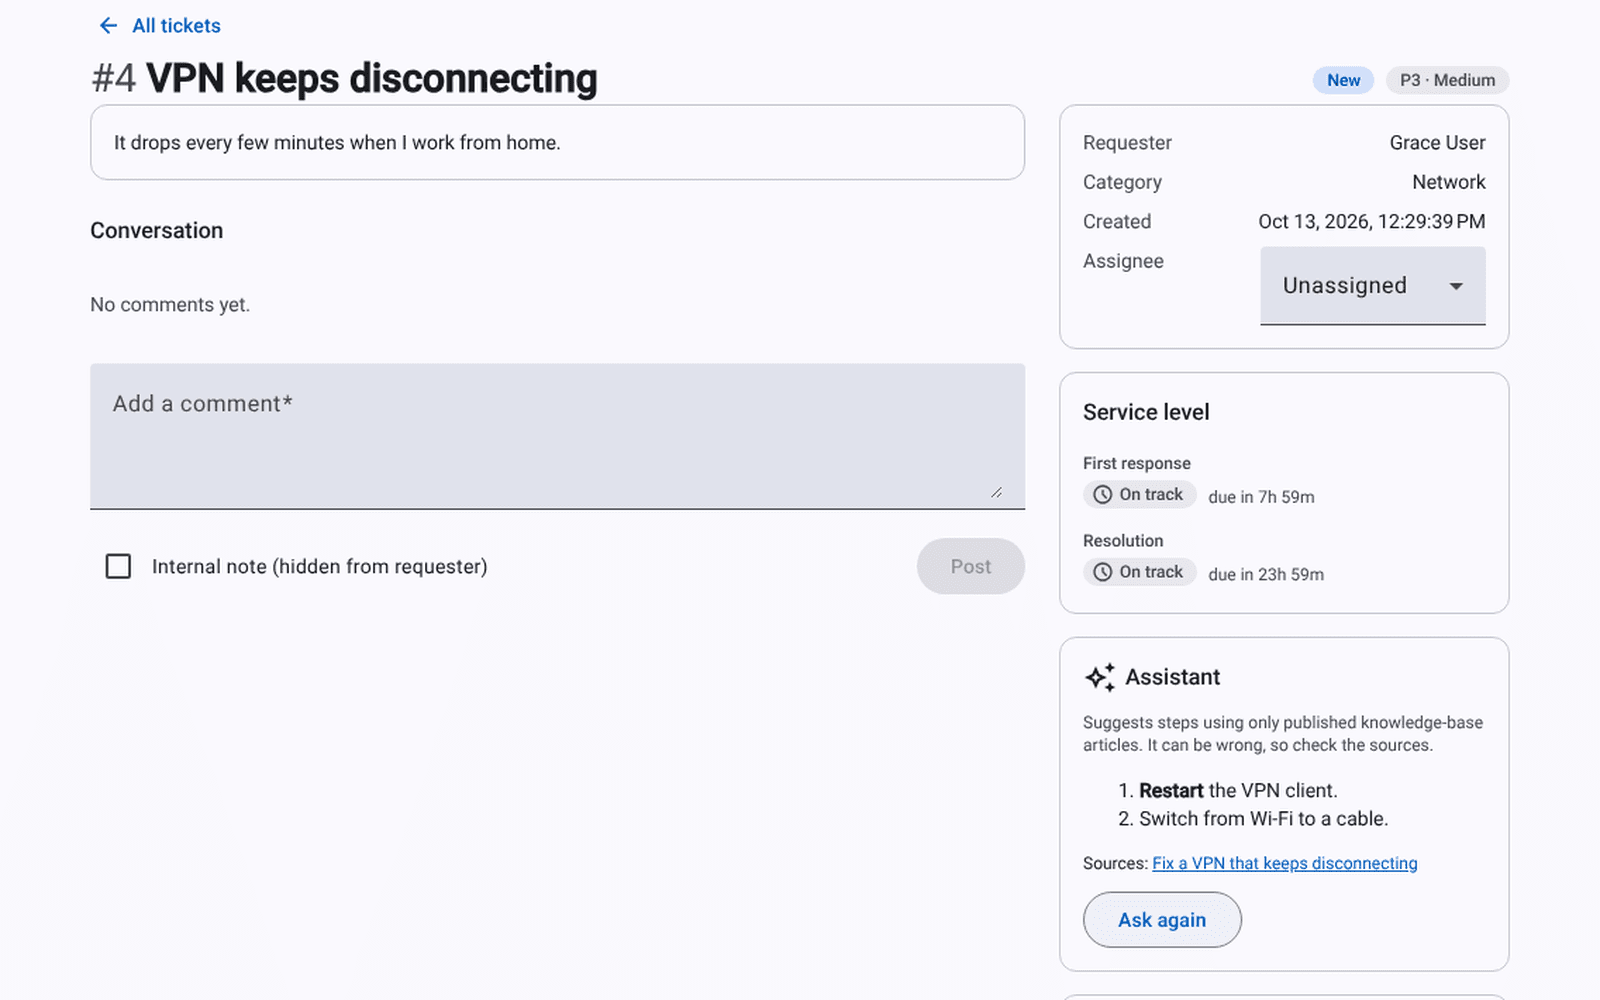
Assistenten på ett ärende: föreslagna steg och den publicerade artikel de kommer från. 04Sökning i Postgres i stället för en söktjänst
Kunskapsbasen använder fulltextsökning i PostgreSQL: en genererad tsvector-kolumn med GIN-index, rubriker rankas högre än brödtext, böjningsformer matchas (”printers” hittar ”printer”) och den förstår ”exakta fraser” och -uteslutningar. Frågor går via websearch_to_tsquery, så konstig inmatning ger aldrig fel.
Träffarna markeras med egna avgränsningstecken i stället för HTML, så webbläsaren behöver aldrig lita på markup från databasen.
Avvägning: En tjänst mindre att drifta och hålla i synk, mot att man går miste om sådant en riktig sökmotor ger, som tolerans för stavfel.
05Tester mot en riktig databas
Backendtesterna körs mot PostgreSQL, inte SQLite, var och en i en transaktion som rullas tillbaka efteråt. Det fångar det SQLite skulle dölja: constraints, sekvenser och fulltextsökning.
Det lärde mig också en fälla. Eftersom testerna delar en session som rullas tillbaka gick en route som glömt att spara sina ändringar ändå igenom. Routes som skriver har nu tester som uttryckligen kontrollerar att ändringen sparas.
03.Resultat
- 259 backendtester mot PostgreSQL och 163 frontendtester, som körs i CI vid varje push
- Driftsatt på Railway som fem tjänster: Angular bakom nginx, FastAPI-API:t, en bakgrundsworker, PostgreSQL och Redis
- En livedemo med tre roller som återställer sig själv varje natt och behåller sin historik
- Behörighet som kontrolleras på servern: beställare ser bara sina egna ärenden, och någon annans ärende ger 404, inte 403, så id:n inte kan gissas
04.Vad jag skulle göra annorlunda
SLA i arbetstid från början
Riktiga servicedeskar mäter SLA i arbetstid, med helgdagar. Jag skulle modellera en kalender per team från första dagen; att lägga till det nu skulle påverka varje deadline-beräkning.
Mät assistentens svar
Jag testade anropens format mot det riktiga SDK:t och logiken med en låtsasmodell, men mätte aldrig kvaliteten på svaren. Nästa steg vore att samla riktiga ärenden med de artiklar som borde besvara dem och betygsätta assistenten mot dem.
Notiser före finputs
Mejlnotiser och bilagor finns fortfarande på listan. Det är vad ett riktigt team skulle behöva först, så jag skulle bygga dem före en del av detaljarbetet.